Daniel Garcia
IA local: quando faz sentido correr um modelo no nosso próprio computador?
English version →Ter um modelo de IA a correr no nosso computador parece uma boa ideia. Mas entre a memória disponível, a velocidade das respostas e a qualidade dos resultados, há escolhas que fazem toda a diferença. Antes de pensar no modelo maior, vale a pena perceber qual é o suficiente para o trabalho que queremos fazer.
Neste artigo
Há qualquer coisa de apelativo na ideia de ter um modelo de inteligência artificial a correr no nosso próprio computador.
Não há API para configurar, não precisamos de enviar tudo para um serviço externo e, em teoria, depois de o modelo estar descarregado podemos conversar com ele sem estar a contar pedidos, tokens ou custos por utilização.
Foi precisamente essa curiosidade que me levou a experimentar IA local. Instalar o Ollama é relativamente simples, descarregar um modelo também não é nenhum ritual secreto e, poucos minutos depois, podemos estar a fazer perguntas a um modelo que está efetivamente a correr na nossa máquina.
Até aqui, tudo muito bonito.
O problema aparece quando fazemos a pergunta seguinte:
Agora que consigo correr um modelo localmente, consigo realmente trabalhar com ele?
E aqui a resposta deixa de ser apenas “sim” ou “não”.
Depende do modelo, da tarefa, do hardware e, sobretudo, daquilo que esperamos obter.
IA local não significa necessariamente hardware de milhares de euros
Quando falamos de inteligência artificial local, existe alguma tendência para imaginar logo uma workstation com uma placa gráfica enorme, dezenas de gigabytes de memória e uma fonte de alimentação capaz de aquecer uma pequena divisão no inverno.
Não tem obrigatoriamente de ser assim.
Hoje existem modelos relativamente pequenos que conseguem correr em computadores perfeitamente normais e que são suficientemente rápidos para pequenas tarefas.
Podemos utilizá-los para:
- classificar texto;
- extrair determinada informação;
- fazer pequenas transformações;
- resumir conteúdos curtos;
- gerar respostas estruturadas;
- executar automações simples;
- ajudar em pequenas tarefas de programação;
- trabalhar com informação que preferimos manter local.
Isto já é utilização real de IA.
Um modelo não precisa de escrever uma aplicação inteira ou analisar centenas de páginas para ser útil.
Na documentação atual da família Gemma, por exemplo, a Google posiciona modelos de 270 milhões e 1 bilião de parâmetros para dispositivos móveis e computadores de placa única, modelos de 4B para desktops e pequenos servidores e variantes maiores para hardware progressivamente mais exigente.
Ou seja, existe todo um espectro entre “um modelo cabe no meu computador” e “preciso de uma pequena central elétrica”.
O primeiro teste é quase sempre divertido
Com ferramentas como o Ollama, a experiência inicial é bastante simples.
Instalamos a ferramenta, escolhemos um modelo e executamos algo do género:
ollama run nome-do-modeloPouco depois temos um prompt à nossa frente e começamos naturalmente pelos clássicos:
Explica isto.
Resume aquilo.
Escreve uma função para fazer não sei o quê.
E funciona.
É nessa altura que começamos a pensar que talvez possamos substituir metade dos serviços cloud que usamos.
Depois descarregamos um modelo maior.
E outro.
E começamos a perceber que o número de parâmetros não é apenas um detalhe escrito na página de download.
Modelos pequenos: rápidos, leves e bastante úteis
Um dos pontos que considero mais interessantes na evolução recente da IA é a capacidade crescente dos modelos pequenos.
Um modelo com poucos milhares de milhões de parâmetros pode hoje resolver tarefas que, há relativamente pouco tempo, associávamos a modelos significativamente maiores.
A Microsoft mostrou isso de forma bastante clara com a família Phi. O Phi-4-mini, com 3,8 mil milhões de parâmetros, foi concebido precisamente para obter bastante capacidade num modelo compacto e, segundo o respetivo trabalho técnico, consegue em algumas tarefas aproximar-se ou ultrapassar modelos bastante maiores.
Isto não significa que um modelo de 3B ou 4B seja equivalente aos melhores modelos disponíveis na cloud.
Não é.
Significa que já existe uma grande quantidade de tarefas para as quais simplesmente não precisamos do maior modelo disponível.
Se quero classificar mensagens, extrair campos de um texto, converter uma pequena descrição numa estrutura JSON ou ajudar uma automação local a tomar uma decisão limitada, um modelo pequeno pode ser precisamente a ferramenta certa.
E, nesse cenário, IA local começa a fazer bastante sentido.
Depois aumentamos a ambição
O problema começa normalmente quando deixamos de pedir pequenas tarefas e passamos para trabalhos mais exigentes.
Queremos:
- analisar documentos extensos;
- trabalhar com contextos grandes;
- gerar bastante código;
- compreender projetos complexos;
- fazer raciocínio mais profundo;
- comparar muita informação;
- manter conversas longas;
- obter respostas com qualidade próxima dos melhores serviços cloud.
É nessa altura que começamos a sentir o peso do modelo.
Literalmente.
Um modelo maior ocupa mais espaço em disco, precisa de mais memória e exige maior capacidade de processamento. Se uma parte significativa do modelo não couber na memória da GPU, alguma carga pode ter de passar pela memória do sistema e pela CPU, normalmente com impacto relevante na velocidade.
O modelo pode continuar a funcionar.
Mas existe uma diferença importante entre funcionar e ser agradável de utilizar diariamente.
Esperar vários segundos por uma pequena resposta ainda pode ser perfeitamente aceitável. Esperar muito tempo por cada iteração enquanto estamos a programar, rever documentação ou experimentar prompts acaba por alterar completamente a experiência.
Foi aí que percebi que “correr” não chega
Nos meus próprios testes com Ollama experimentei modelos de dimensões bastante diferentes.
Os modelos pequenos demonstraram rapidamente uma vantagem: para tarefas delimitadas, respondem depressa e o computador continua perfeitamente utilizável.
Quando passamos para modelos muito maiores, a qualidade potencial aumenta, mas também aumenta o custo computacional.
No meu caso, foi possível executar modelos maiores em hardware bastante modesto para os padrões atuais de IA. Isso, por si só, já é interessante.
Mas também ficou claro que conseguir carregar um modelo e receber uma resposta não significa necessariamente termos uma ferramenta produtiva.
Se cada interação importante implica esperar demasiado, acabamos por voltar à cloud para muitas tarefas.
E isso levou-me à pergunta que considero realmente importante:
Qual é o menor modelo capaz de resolver bem o problema que tenho?
Essa pergunta é muito mais útil do que:
Qual é o maior modelo que consigo instalar?
A memória tornou-se parte da conversa
Quando pensamos em montar um computador para IA local, rapidamente chegamos à RAM e à VRAM.
E os últimos tempos não têm sido particularmente simpáticos para quem pretende comprar memória.
A forte procura associada a servidores e infraestrutura de inteligência artificial tem pressionado a oferta. Durante 2026, a TrendForce reportou aumentos muito significativos nos preços contratuais de DRAM e NAND e continuou a apontar para um mercado apertado ao longo do ano.
A memória gráfica também não ficou isolada deste problema, porque fabricantes têm capacidade de produção limitada e existe uma enorme procura por componentes destinados a infraestrutura de IA.
Isto cria uma situação curiosa.
Por um lado, queremos mais RAM e mais VRAM para correr modelos maiores.
Por outro, esse hardware ficou mais caro precisamente devido ao crescimento da própria inteligência artificial.
A IA está, de certa forma, a encarecer o hardware que precisamos para correr IA.
Há aqui alguma ironia.
Mas os modelos também estão a evoluir
Felizmente, a evolução não acontece apenas no lado do hardware.
Os modelos estão também a tornar-se mais eficientes.
Técnicas como quantização permitem representar os pesos de um modelo com menos bits, reduzindo significativamente a memória necessária.
Um estudo publicado em 2026 sobre eficiência de Small Language Models encontrou, no cenário testado, uma redução de cerca de 71% no consumo máximo de memória e um aumento de 83% no throughput ao aplicar quantização de 4 bits a um Phi-3-mini, com uma degradação relativamente pequena em vários testes.
Os números concretos variam entre modelos, hardware e técnicas utilizadas, mas o princípio é importante:
Podemos reduzir bastante os requisitos de um modelo sem perder proporcionalmente a sua utilidade.
Os próprios fabricantes estão a desenhar modelos pensando cada vez mais na execução local.
A Google disponibiliza variantes Gemma explicitamente direcionadas para dispositivos móveis, portáteis, desktops e pequenos servidores. Ferramentas como o Ollama continuam também a melhorar os motores de inferência e o suporte a formatos quantizados.
Portanto, enquanto o hardware tem ficado mais caro, o software está a aprender a aproveitar melhor aquilo que já temos.
Um modelo pequeno não é um modelo inútil
Existe ainda uma ideia que considero importante desfazer.
Às vezes avaliamos modelos locais com a mesma pergunta com que avaliamos os maiores modelos cloud:
Consegue fazer tudo?
Provavelmente não.
Mas talvez essa seja a pergunta errada.
Um servidor DNS também não edita vídeo, e ninguém considera isso uma limitação particularmente preocupante.
Uma ferramenta deve ser avaliada pela tarefa para a qual foi escolhida.
Um modelo pequeno pode ser excelente para uma automação interna que recebe uma mensagem e escolhe entre cinco categorias.
Pode ser suficiente para transformar texto numa estrutura.
Pode responder a perguntas sobre uma pequena coleção de documentação.
Pode tratar informação confidencial que não queremos enviar para serviços externos.
Pode funcionar sem Internet.
Pode integrar uma aplicação local sem custos variáveis por chamada.
Nesse tipo de utilização, o objetivo não é competir com o maior modelo existente.
É resolver bem um problema concreto.
Quando IA local faz sentido
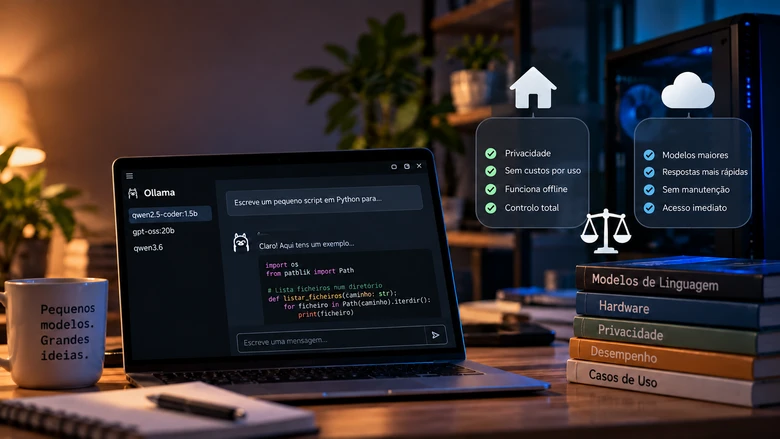
Depois de experimentar diferentes modelos e perceber melhor as limitações, existem alguns cenários onde vejo claramente vantagens na utilização local.
Privacidade
Os dados não precisam de sair da máquina ou da infraestrutura que controlamos.
Isto pode ser importante quando trabalhamos com:
- documentos internos;
- informação empresarial;
- dados de clientes;
- código proprietário;
- conteúdo que simplesmente não queremos enviar para terceiros.
Isto não elimina a necessidade de segurança. Apenas altera onde os dados são processados.
Funcionamento offline
Depois de descarregado o modelo, muitas soluções podem funcionar sem acesso à Internet.
Para determinadas ferramentas internas ou ambientes isolados, isto pode ser bastante útil.
Automações pequenas e frequentes
Se temos uma tarefa bem definida que é executada muitas vezes, um modelo local pode evitar chamadas constantes a uma API.
Aqui um modelo pequeno pode ser particularmente interessante.
Experimentação e aprendizagem
Há também uma vantagem que não aparece numa folha de cálculo.
Correr modelos localmente ajuda-nos a perceber melhor como tudo isto funciona.
Começamos a prestar atenção a parâmetros, quantização, contexto, memória, CPU, GPU e throughput.
Deixamos de olhar para a IA apenas como uma caixa de texto num browser.
Controlo da infraestrutura
Podemos escolher o modelo, a versão, os limites e quando o queremos atualizar.
Para determinados projetos, essa previsibilidade pode ser mais importante do que utilizar permanentemente o modelo mais recente.
Quando provavelmente não compensa
Também existem situações onde IA local pode ser apenas uma forma complicada de resolver um problema que já estava resolvido.
Precisamos regularmente dos modelos mais capazes
Se o trabalho exige raciocínio complexo, contextos enormes, geração de código avançada ou análise intensiva, um serviço cloud pode oferecer muito mais capacidade sem precisarmos de comprar e manter a infraestrutura.
Queremos velocidade com modelos grandes
Um modelo grande pode correr localmente, mas para ser realmente rápido pode exigir uma quantidade substancial de VRAM e hardware de gama elevada.
É possível.
A pergunta é se economicamente faz sentido.
Utilizamos IA ocasionalmente
Investir milhares de euros em hardware para executar localmente algo que utilizamos algumas vezes por semana pode não ser uma grande decisão financeira.
Uma API paga apenas quando é utilizada.
Uma GPU cara continua a estar cara mesmo quando está desligada.
Não queremos administrar mais uma infraestrutura
Drivers, versões, modelos, espaço em disco, atualizações, compatibilidade e monitorização também têm um custo.
Não aparece necessariamente na fatura da eletricidade, mas aparece no nosso tempo.
Local ou cloud? Talvez a resposta seja “os dois”
Durante algum tempo, a discussão sobre IA local pareceu seguir a lógica habitual da tecnologia:
Qual delas é melhor?
Mas talvez não seja necessário escolher um lado.
Podemos utilizar modelos locais para:
- tarefas simples;
- informação sensível;
- automações;
- classificação;
- processamento offline;
- experiências.
E recorrer à cloud quando precisamos de:
- modelos muito maiores;
- raciocínio avançado;
- contextos extensos;
- elevada velocidade;
- funcionalidades especializadas.
Uma arquitetura híbrida permite escolher a ferramenta em função da tarefa.
E, tecnicamente, isso parece-me muito mais interessante do que tentar obrigar um único modelo a fazer tudo.
E daqui a dois ou três anos?
Aqui entramos necessariamente no campo da previsão.
Não podemos afirmar que daqui a dois anos qualquer computador barato vai correr modelos equivalentes aos melhores sistemas cloud atuais.
Mas existe uma tendência que me parece difícil ignorar.
Os modelos pequenos estão a tornar-se mais capazes.
A quantização está a melhorar.
As arquiteturas estão a tornar-se mais eficientes.
Os motores de inferência estão a aproveitar melhor o hardware.
E os próprios fabricantes estão a desenhar modelos especificamente destinados a execução em computadores pessoais e dispositivos móveis.
Isto significa que a fronteira está a mover-se.
O que hoje exige uma workstation muito cara pode não exigir o mesmo investimento no futuro.
E aquilo que hoje consideramos um “modelo pequeno” pode oferecer capacidades que atualmente associamos a modelos bastante maiores.
Por isso, considero perfeitamente plausível que, a curto e médio prazo, seja possível ter modelos locais suficientemente capazes para uma parte muito maior do trabalho diário sem que isso implique obrigatoriamente investir milhares de euros em hardware.
Curiosamente, isto pode acontecer enquanto RAM e placas gráficas continuam caras.
A pergunta certa não é “qual é o maior modelo?”
Depois destas experiências, a minha visão sobre IA local ficou bastante mais pragmática.
É perfeitamente possível correr um modelo local rapidamente e sem hardware extraordinário.
Para pequenas operações, pode ser uma solução simples, privada, económica e bastante eficaz.
Também é possível correr modelos grandes localmente.
Mas quando queremos combinar grande capacidade, contexto elevado e respostas rápidas, o investimento em hardware sobe consideravelmente e deixa de ser viável para muita gente.
É aqui que temos de separar possibilidade técnica de decisão prática.
Só porque conseguimos fazer uma coisa não significa que seja a melhor forma de a fazer.
E talvez o futuro da IA local não esteja em termos em casa o maior modelo possível.
Talvez esteja precisamente no contrário:
ter o menor modelo capaz de resolver bem o problema que temos.
Se essa fronteira continuar a deslocar-se ao ritmo atual, aquilo que hoje é uma experiência interessante para quem gosta de mexer em tecnologia pode tornar-se, mais depressa do que pensamos, uma opção perfeitamente normal para trabalhar todos os dias.
Notas
Parâmetros
Valores internos aprendidos durante o treino de um modelo. De forma simplificada, modelos com mais parâmetros tendem a ter maior capacidade, mas também exigem mais recursos. O número de parâmetros, por si só, não determina a qualidade.
VRAM — Video Random Access Memory
Memória disponível na placa gráfica. Na inferência local, é frequentemente um dos fatores que mais limita o tamanho do modelo que conseguimos executar diretamente na GPU.
Quantização
Técnica que reduz a precisão utilizada para representar os pesos de um modelo, permitindo diminuir o espaço ocupado e a memória necessária para o executar. Existe normalmente algum compromisso entre eficiência e qualidade.
Throughput
Quantidade de trabalho processado por unidade de tempo. Em modelos de linguagem é frequentemente medido em tokens por segundo.
Inferência
Fase em que um modelo já treinado recebe uma entrada e produz uma resposta. É o que acontece quando fazemos uma pergunta a um modelo local.
Documentação e fontes de apoio
- Google AI for Developers: modelos Gemma e plataformas recomendadas
- Google AI for Developers: visão geral do Gemma 4 e modelos quantizados
- Microsoft Research: Phi-4-Mini Technical Report
- Microsoft Research: Phi-3 Technical Report
- Ollama: melhorias de desempenho e quantização
- Strategies for computational efficiency in small language models
- TrendForce: mercado de memória no 4.º trimestre de 2026
- TrendForce: impacto da procura de servidores de IA nos preços da memória